Saltar al contenido principal
ESTADISTICA 
INFERENCIAL 
WILLIAN DELGADO 
C.I 22,333,432
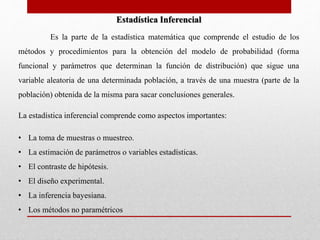
Estadística Inferencial 
Es la parte de la estadística matemática que comprende el estudio de los 
métodos y procedimientos para la obtención del modelo de probabilidad (forma 
funcional y parámetros que determinan la función de distribución) que sigue una 
variable aleatoria de una determinada población, a través de una muestra (parte de la 
población) obtenida de la misma para sacar conclusiones generales. 
La estadística inferencial comprende como aspectos importantes: 
• La toma de muestras o muestreo. 
• La estimación de parámetros o variables estadísticas. 
• El contraste de hipótesis. 
• El diseño experimental. 
• La inferencia bayesiana. 
• Los métodos no paramétricos
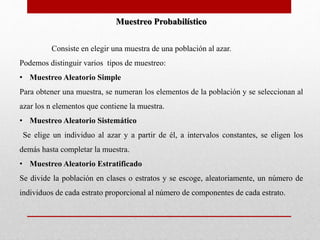
Muestreo Probabilístico 
Consiste en elegir una muestra de una población al azar. 
Podemos distinguir varios tipos de muestreo: 
• Muestreo Aleatorio Simple 
Para obtener una muestra, se numeran los elementos de la población y se seleccionan al 
azar los n elementos que contiene la muestra. 
• Muestreo Aleatorio Sistemático 
Se elige un individuo al azar y a partir de él, a intervalos constantes, se eligen los 
demás hasta completar la muestra. 
• Muestreo Aleatorio Estratificado 
Se divide la población en clases o estratos y se escoge, aleatoriamente, un número de 
individuos de cada estrato proporcional al número de componentes de cada estrato.
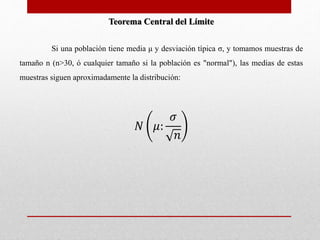
Teorema Central del Límite 
Si una población tiene media μ y desviación típica σ, y tomamos muestras de 
tamaño n (n>30, ó cualquier tamaño si la población es "normal"), las medias de estas 
muestras siguen aproximadamente la distribución: 
푁 휇: 
휎 
푛
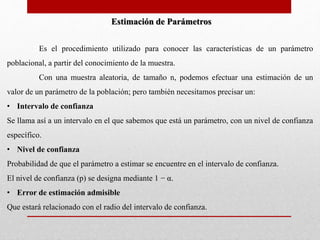
Estimación de Parámetros 
Es el procedimiento utilizado para conocer las características de un parámetro 
poblacional, a partir del conocimiento de la muestra. 
Con una muestra aleatoria, de tamaño n, podemos efectuar una estimación de un 
valor de un parámetro de la población; pero también necesitamos precisar un: 
• Intervalo de confianza 
Se llama así a un intervalo en el que sabemos que está un parámetro, con un nivel de confianza 
específico. 
• Nivel de confianza 
Probabilidad de que el parámetro a estimar se encuentre en el intervalo de confianza. 
El nivel de confianza (p) se designa mediante 1 − α. 
• Error de estimación admisible 
Que estará relacionado con el radio del intervalo de confianza.
Ejemplos de Estadística Inferencial 
Aquí presentamos 3 ejemplo donde se aplica la Estadística Inferencial: 
• Una encuesta desarrollada por una empresa en marzo del 2010, dice que el rating de radio 
en Madrid esta encabezado por OC con un 10,5% seguido de RNE con 9,18% 
• De acuerdo con una encuesta desarrollada por una empresa sobre telefonía residencial en 
el 2009, el gasto mensual promedia por cliente es de 90,30 euros por cliente. 
• El INI informó que la Encuesta Permanente de Hogares del mes de marzo 2010 reporto la 
tasa más alta de desempleo que ascendió al 20% a nivel nacional.
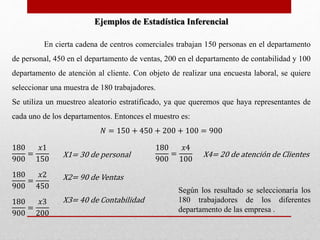
En cierta cadena de centros comerciales trabajan 150 personas en el departamento 
de personal, 450 en el departamento de ventas, 200 en el departamento de contabilidad y 100 
departamento de atención al cliente. Con objeto de realizar una encuesta laboral, se quiere 
seleccionar una muestra de 180 trabajadores. 
Se utiliza un muestreo aleatorio estratificado, ya que queremos que haya representantes de 
cada uno de los departamentos. Entonces el muestro es: 
푁 = 150 + 450 + 200 + 100 = 900 
180 
900 
= 
푥1 
150 
180 
900 
= 
푥4 
100 
180 
900 
= 
푥2 
450 
180 
900 
= 
푥3 
200 
Ejemplos de Estadística Inferencial 
X1= 30 de personal 
X2= 90 de Ventas 
X3= 40 de Contabilidad 
X4= 20 de atención de Clientes 
Según los resultado se seleccionaría los 
180 trabajadores de los diferentes 
departamento de las empresa .
Distribución de Probabilidad 
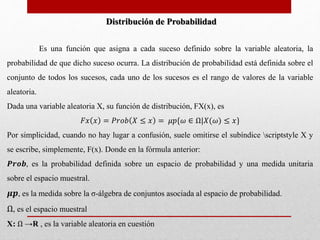
Es una función que asigna a cada suceso definido sobre la variable aleatoria, la 
probabilidad de que dicho suceso ocurra. La distribución de probabilidad está definida sobre el 
conjunto de todos los sucesos, cada uno de los sucesos es el rango de valores de la variable 
aleatoria. 
Dada una variable aleatoria X, su función de distribución, FX(x), es 
퐹푥 푥 = 푃푟표푏 푋 ≤ 푥 = 휇푝{휔 ∈ Ω|푋(휔) ≤ 푥} 
Por simplicidad, cuando no hay lugar a confusión, suele omitirse el subíndice scriptstyle X y 
se escribe, simplemente, F(x). Donde en la fórmula anterior: 
푷풓풐풃, es la probabilidad definida sobre un espacio de probabilidad y una medida unitaria 
sobre el espacio muestral. 
흁풑, es la medida sobre la σ-álgebra de conjuntos asociada al espacio de probabilidad. 
Ω, es el espacio muestral 
X: Ω →R , es la variable aleatoria en cuestión
Distribución Variable Aleatoria Discreta 
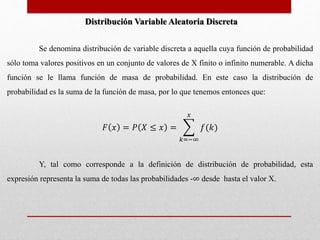
Se denomina distribución de variable discreta a aquella cuya función de probabilidad 
sólo toma valores positivos en un conjunto de valores de X finito o infinito numerable. A dicha 
función se le llama función de masa de probabilidad. En este caso la distribución de 
probabilidad es la suma de la función de masa, por lo que tenemos entonces que: 
퐹 푥 = 푃 푋 ≤ 푥 = 
푥 
푘=−∞ 
푓(푘) 
Y, tal como corresponde a la definición de distribución de probabilidad, esta 
expresión representa la suma de todas las probabilidades -∞ desde hasta el valor X.
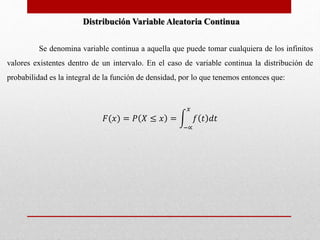
Distribución Variable Aleatoria Continua 
Se denomina variable continua a aquella que puede tomar cualquiera de los infinitos 
valores existentes dentro de un intervalo. En el caso de variable continua la distribución de 
probabilidad es la integral de la función de densidad, por lo que tenemos entonces que: 
퐹(푥) = 푃 푋 ≤ 푥 = 
푥 
푓 푡 푑푡 
−∝
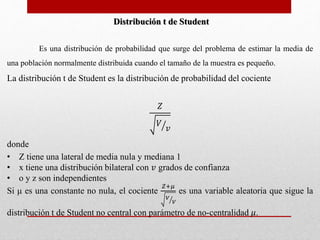
Distribución t de Student 
Es una distribución de probabilidad que surge del problema de estimar la media de 
una población normalmente distribuida cuando el tamaño de la muestra es pequeño. 
La distribución t de Student es la distribución de probabilidad del cociente 
푍 
푉 
푣 
donde 
• Z tiene una lateral de media nula y mediana 1 
• x tiene una distribución bilateral con 푣 grados de confianza 
• o y z son independientes 
푍+휇 
Si μ es una constante no nula, el cociente 
푉 
푉 
es una variable aleatoria que sigue la 
distribución t de Student no central con parámetro de no-centralidad 휇.
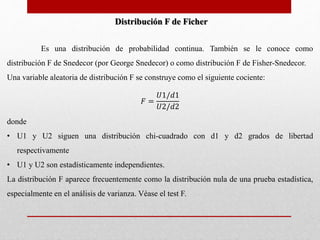
Distribución F de Ficher 
Es una distribución de probabilidad continua. También se le conoce como 
distribución F de Snedecor (por George Snedecor) o como distribución F de Fisher-Snedecor. 
Una variable aleatoria de distribución F se construye como el siguiente cociente: 
퐹 = 
푈1/푑1 
푈2/푑2 
donde 
• U1 y U2 siguen una distribución chi-cuadrado con d1 y d2 grados de libertad 
respectivamente 
• U1 y U2 son estadísticamente independientes. 
La distribución F aparece frecuentemente como la distribución nula de una prueba estadística, 
especialmente en el análisis de varianza. Véase el test F.